RSS-AI论文订阅工具升级
AI还是太好用了。
在codex的帮助下,更新了一下先前开发的那个基于RSS的论文订阅追踪工具+AI解读工具。先前对这个工具的介绍,参考这篇文章: 《基于RSS订阅源以及LLM的文献订阅追踪工具》 。这一次,则修补了很多之前不够完善的功能。
本文由我与codex(DeepSeek)合作创建。以下是正文。
零、背景
如题。
距离我上一次介绍这个项目,已经过去了一段时间。初版发布之后,又有了很多反思,功能本身是完整的,但用起来还是不够顺手:关键词写死在代码里、想换模型要改源码、报告只能自己打开文件看。于是这段时间里,我在不改变原有处理流程的基础上,把项目做了一次偏“易用性”的升级。
这篇文章想聊清楚三件事:
- 相比初版,这次到底升级了什么;
- 每一项升级解决了什么问题;
- 现在这套工具应该怎么配置和使用。
一、先回顾一下初版做了什么
如果我们没有看过上一篇,也可以直接先看这一段。
这个项目的核心流程没有变化,依然是:
- 解析 OPML 文件,读取里面保存的期刊 RSS Feed 地址;
- 抓取每个 Feed 最近一段时间的论文标题、摘要、作者和链接;
- 尝试从期刊网页或 PubMed/PMC 获取论文全文;
- 调用大语言模型,按照固定模板解读论文;
- 生成 Markdown 报告,并额外保存一份 JSON、Parquet 和 Excel 文件。
初版最大的问题,我在上一篇的第四部分也总结过:主题关键词硬编码、输出语言写死在 prompt 里、模型接口信息藏在代码中,以及缺少自动推送能力。这次的升级,基本上就是围绕这几点逐一展开的。
二、这次升级了什么
1. 配置全面外置到 YAML
初版中,如果我们想修改关注的话题,或者换一个模型,只能打开源码手动改。现在,这些内容都搬到了一个 config.yaml 文件里。
配置文件主要分为四块:
app:订阅源文件、追踪天数、输出目录和输出语言;llm:大模型的 endpoint、model id、auth key 和超时时间;topics:关注的话题,以及每个话题的正向、反向关键词;email:邮件开关、SMTP 服务器、发件人、授权码和收件人列表。
1 | app: |
这样改动之后,换模型、换邮箱、调整追踪天数都不再需要碰主程序代码。对于刚接触这个项目的同学来说,门槛明显低了不少。
2. 正向关键词之外,增加了反向关键词
这是初版的一个典型痛点。比如我想检索“衰老”相关论文,设置了关键词 aging。但 aging 这个字符串同时也会出现在 imaging、managing 里。于是,一些和衰老完全无关的论文就会被误筛进来。
现在,每个话题下面可以单独设置 negative_keywords。程序在匹配正向关键词之前,会先把这些反向关键词从文本中“mask”掉,再去做正向匹配。
还是拿 aging 举例:
Molecular mechanisms of aging:可以命中;Imaging biomarkers of cancer:imaging被 mask 掉,不再因为其中包含aging被误判;Managing chronic disease:managing被 mask 掉,同样不再误判。
更重要的是,如果一篇文章既包含 aging,又包含 imaging,它仍然可以正常命中。也就是说,反向关键词只解决“子串误判”的问题,不会粗暴地删掉所有带这些词的文章。
3. 大模型配置与调用逻辑简化
初版的 libqwen.py 里,既写死了 API key,又写死了模型列表,还有不少和 CLI 交互相关的内容。对于一个只需要调用接口的任务来说,这些内容有些重。
这次我把 libqwen.py 做了大幅精简,只保留最核心的 HTTP JSON 调用。调用方只需要从 YAML 中读取三样东西:
endpoint_urlmodel_idauth_key
这也意味着,只要我们的服务提供 OpenAI-compatible 的 Chat Completions 接口,就不一定非得使用通义千问。换成一个自建模型、其他云厂商的模型,都可以通过修改配置完成。
4. 输出语言也可以配置
初版的输出语言写在 prompt 模板里,想改成英语,只能去源码里搜索“simplified Chinese”然后替换。现在只需要在 config.yaml 中设置:
1 | app: |
zh 表示简体中文,en 表示英文。程序会自动替换 prompt 中的语言说明,模型解析出的标题翻译和摘要翻译就会按目标语言输出。
5. 增加邮件发送
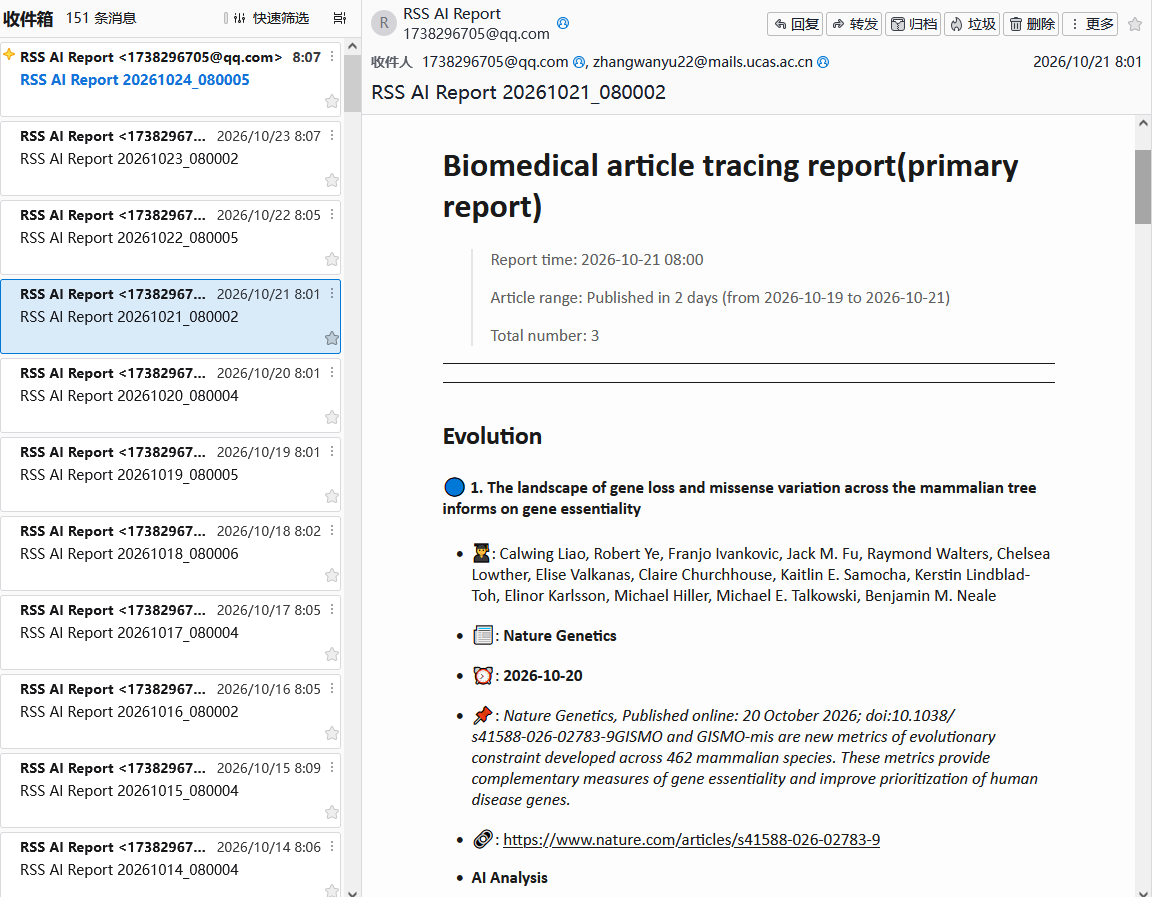
初版里,报告生成后只能自己到 outputs 目录里打开。现在可以在 email 配置中开启邮件推送:
1 | email: |
开启后,程序会在报告生成完成后,自动把报告发送到收件人列表里的所有邮箱。
比方说这样:
6. 检测 Pandoc,并输出 HTML 版报告
这是配合邮件功能一起做的一个小优化。
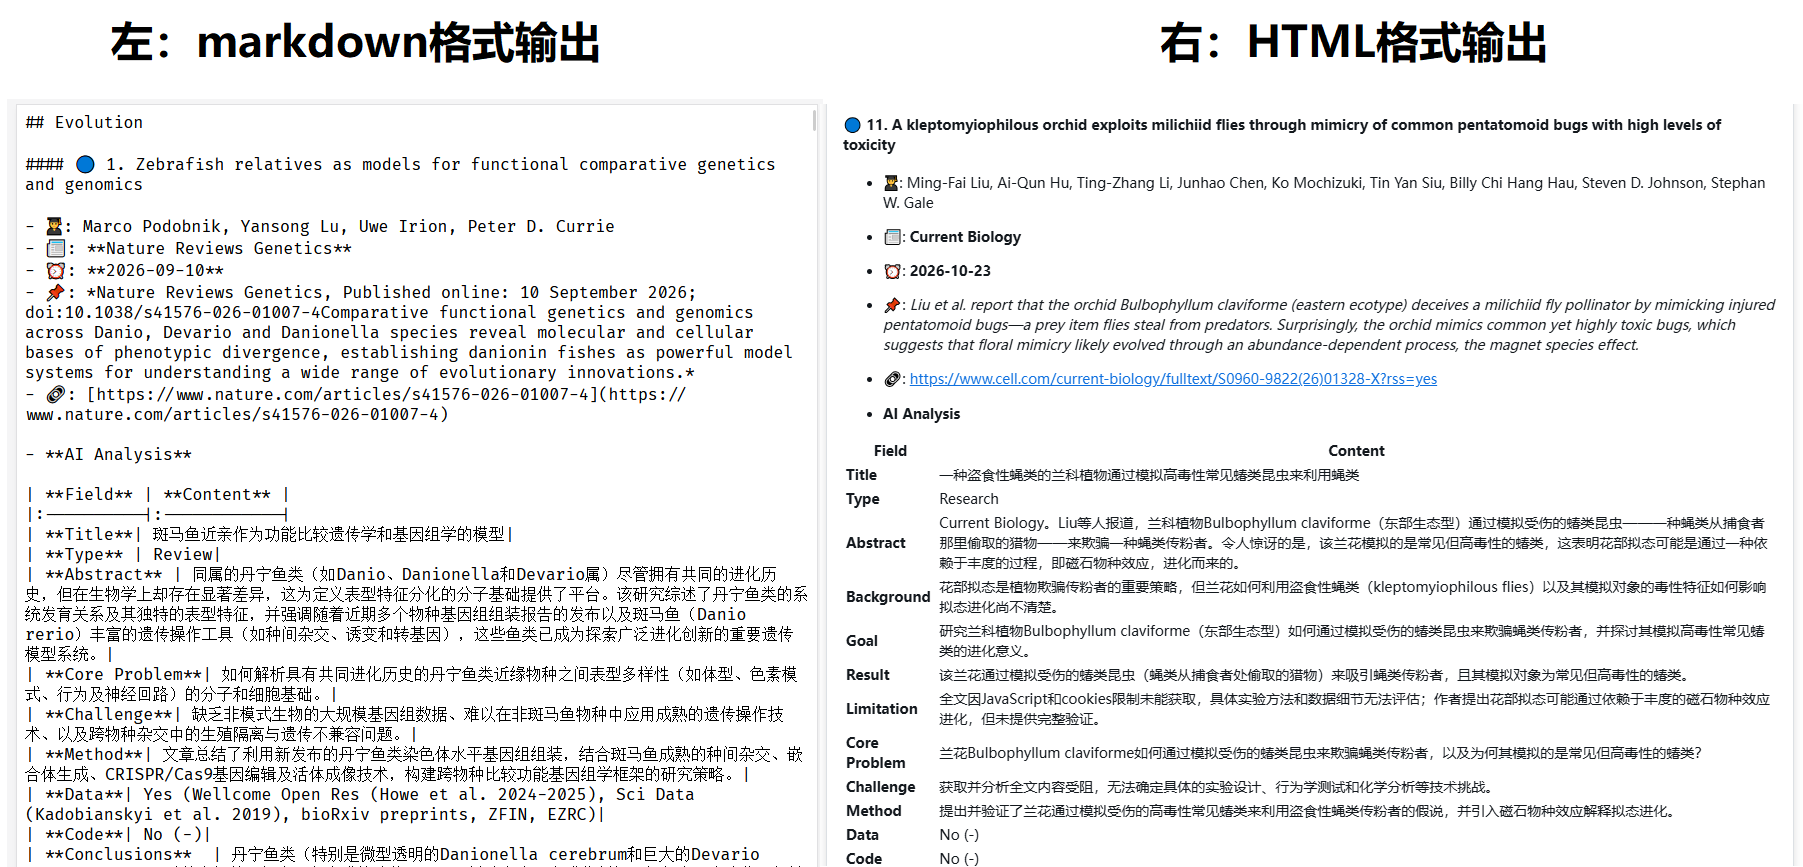
程序会先检测系统中是否存在 Pandoc:
- 如果存在,就在 Markdown 报告之外,再编译一份 HTML 报告;发送邮件时,优先发送这份 HTML 版本;
- 如果不存在,就仍然发送 Markdown 版本。
HTML 版报告在邮件里阅读起来更舒服,标题、表格和链接的排版也更清晰。对于习惯在手机或电脑邮件客户端里阅读报告的人来说,这个改进比较实用。
三、新版使用方法
第一步:准备目录
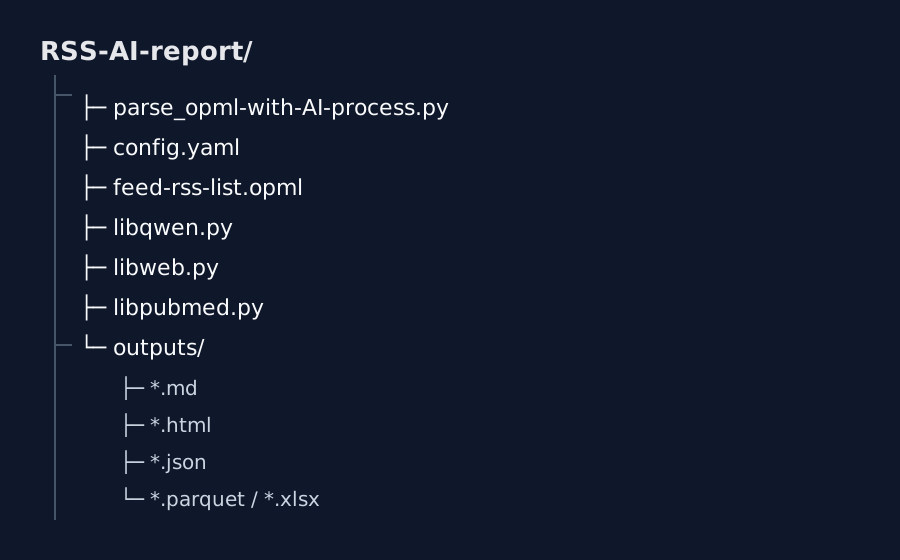
下载项目文件后,保证主程序、OPML 文件和配置文件在同一个工作目录下。
新版目录结构大致如下:
1 | RSS-AI-report/ |
第二步:编辑 config.yaml
把下面几项改成我们自己的信息:
- 如果想换订阅源,修改
app.opml_path; - 如果想调整追踪天数,修改
app.day_limit; - 如果想更换模型,修改
llm.endpoint_url、llm.model_id和llm.auth_key; - 如果想调整关注话题,修改
topics; - 如果想接收邮件,把
email.enabled设为true,并填写发件人和收件人。
第三步:运行
在项目目录下执行:
1 | python parse_opml-with-AI-process.py -c config.yaml |
如果只是临时换一个 OPML 文件或时间范围,也可以继续使用命令行参数覆盖:
1 | python parse_opml-with-AI-process.py -c config.yaml -f my-feeds.opml -d 8 |
目前的命令行参数有三个:
1 | -c CONFIG, --config CONFIG |
第四步:查看输出
运行完成后,output_dir 目录下会生成以下文件:
1 | RSS_primary_report_YYYYMMDD_HHMMSS.json |
如果检测到 Pandoc,还会多一个:
1 | RSS_primary_report_YYYYMMDD_HHMMSS.html |
各文件分别对应:
.json:抓取并过滤后的论文元数据;.md:Markdown 版阅读报告;.parquet:AI 解析过程中保存的中间数据;.xlsx:适合二次筛选和编辑的表格;.html:由 Pandoc 生成的网页版报告。
四、初版的问题,现在解决到哪里了
上一篇结尾我提了三个问题,现在可以对照一下:
- 关键词和语言写死在代码里:已经通过
config.yaml解决; - 没有自动推送:已经通过邮件功能解决;
- 命令行操作门槛高:目前仍然存在,这也是这个项目下一步最想改善的方向。
对于第三点,我仍然保留此前的两个思路:
- 接入 openClaw 之类的自动化 Agent 平台,做成一个 skill,让用户用自然语言调用;
- 或者构建一个更可视化的网页版界面。
不过,在界面方案成熟之前,先把核心逻辑稳定下来、把配置和推送做扎实,可能是更实际的一步。
五、写在最后
这个项目的定位一直没有变:它不是一个“什么都能做”的学术助手,而是一个从源头出发的文献追踪工具。RSS 负责及时性,OPML 负责订阅管理,LLM 负责把论文摘要和全文整理成可读的报告,邮件负责把结果送到我们手上。
如果我们也受够了每周手动刷新几十个期刊,欢迎试试这个新版。配置文件和订阅源都放在仓库里,动手门槛应该比初版低了不少。
如果使用中遇到问题,或者对反向关键词、邮件格式、模型接入有什么建议,欢迎在仓库里留言交流。
以上。