百度天气API的使用,以及ANOMS天气服务的数据源修复
AI还是太好用了。
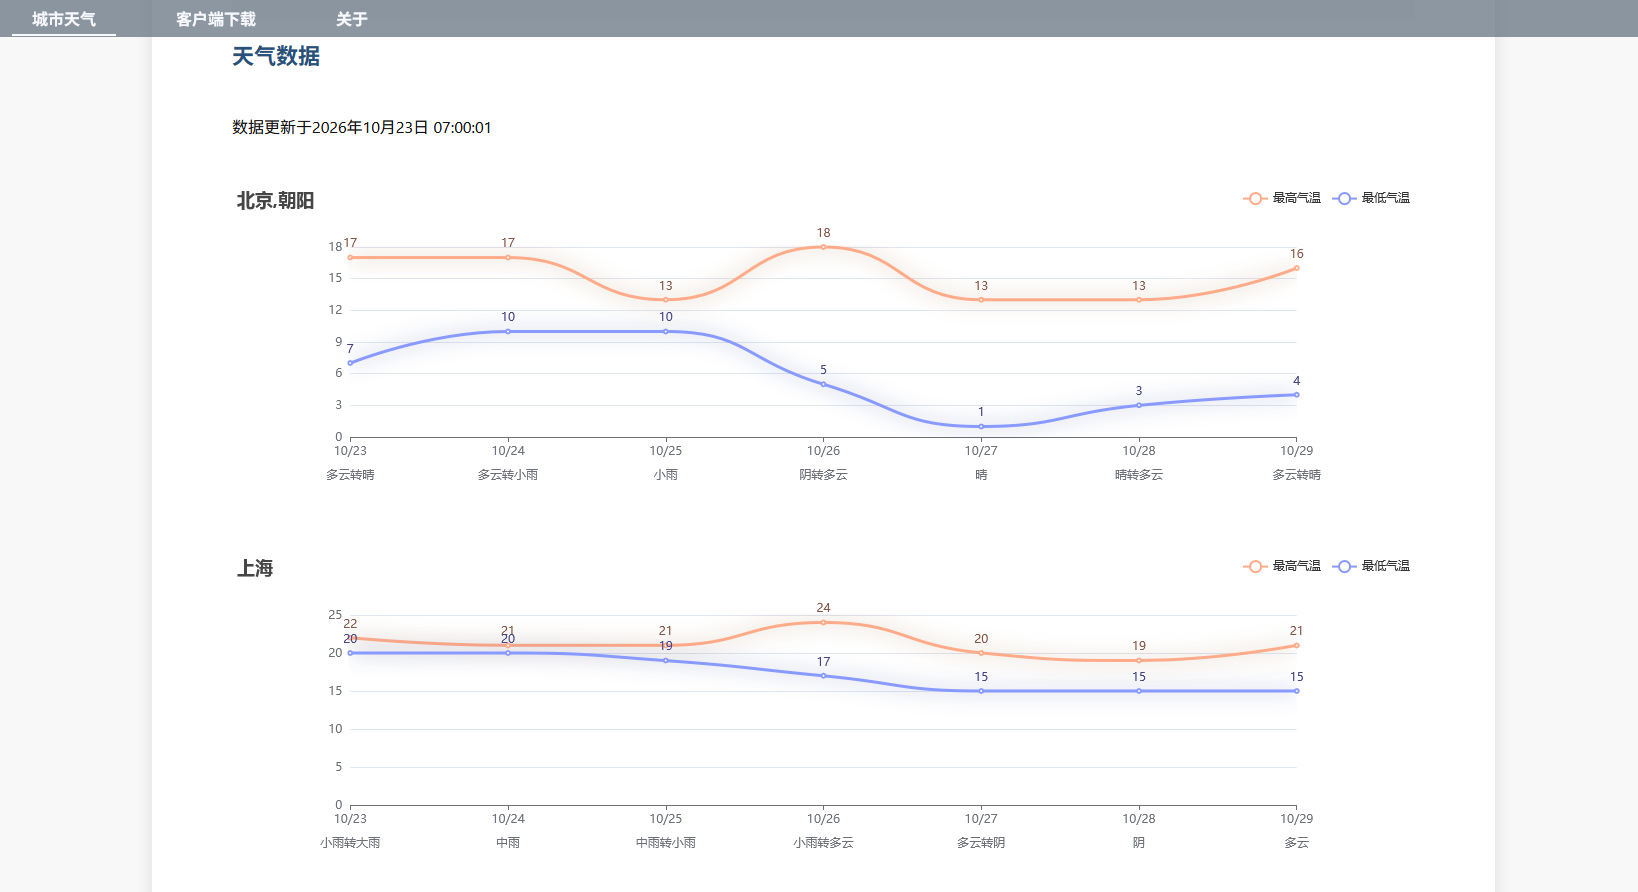
我有一个域名叫做ANOMS。在这个域名下,我托管了好几个服务,除了现在 wz.anoms.top 这个博客以外,还有一个minecraft服务器,以及 ANOMS 天气服务 。最近半年, ANOMS 天气服务 由于中国气象局数据源的问题,服务中断。为了修复问题,我修改了很多底层代码,并把数据源从中国气象局迁移到了百度天气API。目前服务已恢复。
本文由我与codex(DeepSeek)合作创建。以下是正文。
一、背景
(一)想法的起因
ANOMS 天气服务是我从 2020 年就开始维护的一个个人小站。它的核心逻辑其实很简单:用 Python 定时爬取中国气象局的天气预报网页,把结果落成一张 TSV 数据表,再由 PHP 前端负责查询和渲染。站点上线以后断断续续维护了几年,虽然界面说不上精致,但胜在“能用、够用、自己全都能改”,也一直是我折腾服务器和爬虫的一个试验田。
今年(2026 年)5 月前后,我忽然发现网站的数据不再更新了。登录服务器一看,爬虫日志里不再是一条条的城市天气,而是中国气象局网站返回的一串拦截提示:
1 | 您的访问请求可能对网站造成安全威胁,请求已被阻断。您的请求可能存在威胁,已被拦截! |

原来的爬虫是基于 weather.cma.cn 网页结构写的,网页一旦被 WAF 拦截,后面按 BeautifulSoup 的固定索引取内容自然就全部报错,典型的报错是 IndexError: list index out of range。换句话说,不是某个城市的数据取不到了,而是整条数据源都断了。
当时摆在我面前的路无非两条:要么继续和反爬斗争,不断换 UA、换代理、调整解析逻辑;要么干脆换一个更“正规”的数据源。我最后选择了后者——把数据源从“爬网页”切换成“调 API”,也就是百度地图开放平台的天气服务。
(二)补充一些知识点(此章节部分内容由 AI 生成)
什么是 CMA 与 city code
CMA 是中国气象局(China Meteorological Administration)的简称。ANOMS 天气服务最早使用的数据源 https://weather.cma.cn/web/weather/ 正是它的官网天气页面,页面 URL 里最后那串数字就是气象部门的城市代码,例如北京是 54511。
在我的项目里,这个 city code 不只是“爬虫要访问哪个网址”的问题,它还是前端的“城市主键”。前端查询城市天气时,URL 形如:
1 | http://www.anoms.top/weather_get_v4.0/index.php?code=54511,58367,59287 |
也就是说,前端完全靠 city code 来区分城市、组织数据。这也就意味着,无论后端数据源怎么换,输出表第一列最好还是原来的 city code,否则前端就得跟着大改。
什么是百度天气 API 与 district_id
百度地图开放平台也提供天气查询接口,叫“百度地图天气服务”。它的请求格式很简单:
1 | https://api.map.baidu.com/weather/v1/?district_id=<行政区划代码>&data_type=all&ak=<你的AK> |
注意,这里的 district_id 用的是百度自己的“行政区划代码”,和气象局的 city code 不是同一套体系。例如北京的百度区划代码是 110100,而气象局那边是 54511。两套编码规则不同、位数也不同,不能直接互相替代。
这就引出了本次升级里最关键的一步:在后端做一层 city code 转换,把旧的气象局 city code 映射到新的百度 district_id,同时把旧 code 继续保留在输出表里,以维持前端兼容。
二、升级方案
(一)整体思路
新的数据链路可以用一句话概括:run.sh 定时拉起 Python 爬虫,爬虫遍历旧 city code,查表得到百度 district_id,再请求百度天气 API,最后把结果按老格式写回 TSV。前端 PHP 一行都不用改。
相比老版本,变化集中在“取数”这一段:原来是用 requests 抓网页再用 BeautifulSoup 解析,现在是用 requests 调 JSON 接口。解析逻辑从“猜网页结构”变成了“按字段取值”,稳定性和可维护性都好得多。
(二)百度天气 API 的使用方法
这一节单独把百度天气 API 的用法整理出来,也算是我给自己留的一份备忘。
1. 申请 AK 与开通权限
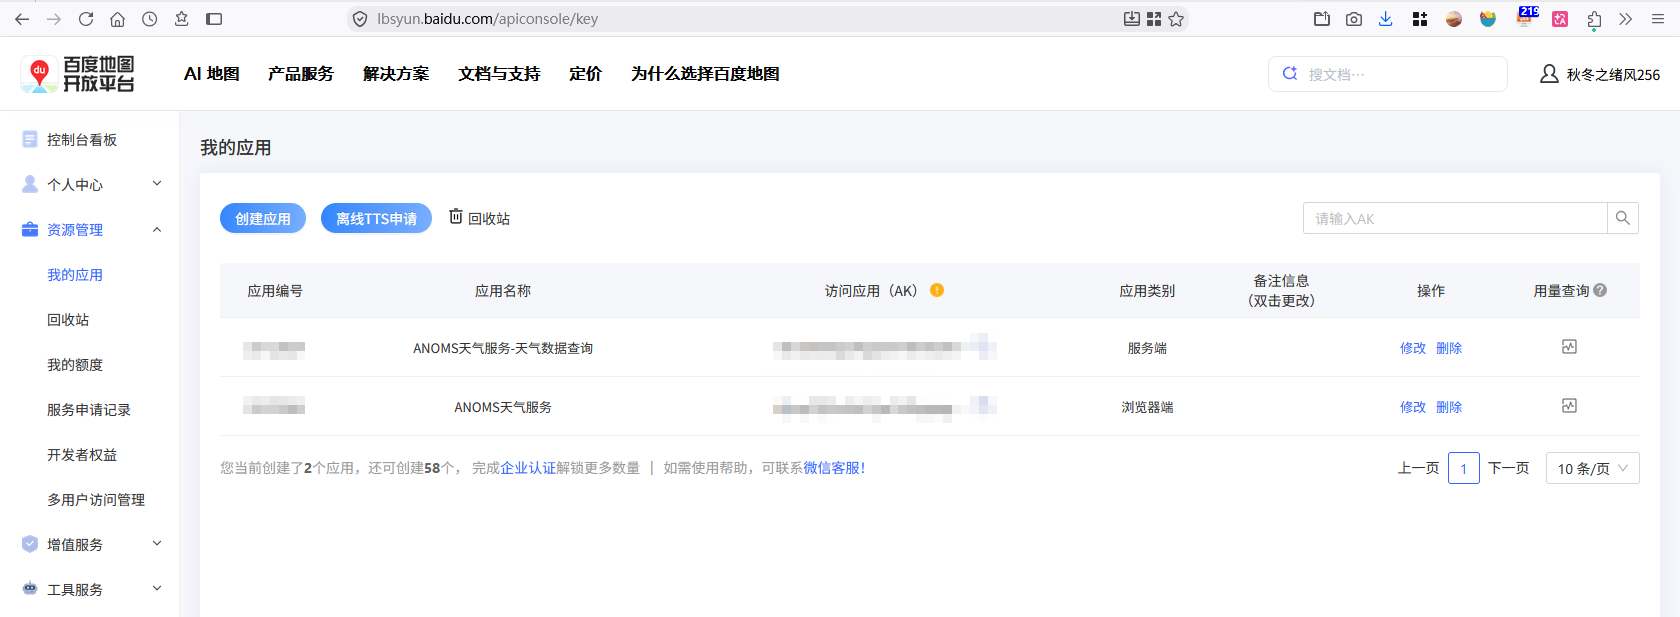
首先要到百度地图开放平台注册开发者账号,创建应用并拿到 AK(API Key)。拿到 AK 之后,还需要单独开通“天气服务”这个接口的权限。天气接口的权限和普通的正逆地理编码、地点检索是分开的,没开通权限直接调用会返回权限错误。
2. 请求参数
天气接口是一个标准的 GET 请求,常用参数如下:
| 参数 | 是否必填 | 含义 | 示例 |
|---|---|---|---|
district_id |
是 | 百度行政区划代码 | 110100 |
data_type |
是 | 返回数据类型 | all、now、fc、index、alert |
ak |
是 | 开发者密钥 | 你的AK |
其中 data_type 是我用得最顺的一个参数。all 会一次性把实时天气、7 天预报、生活指数和预警信息全部返回,省得为不同数据发多次请求。对离线生成数据表的场景来说,一次拿全是最省事的。
3. 请求示例
1 | import requests |
4. 返回字段解读
接口返回的 JSON 里,status 为 0 表示成功,核心数据都在 result 里。对我最有用的三块是 now、forecasts 和 indexes:
| 字段 | 含义 | 说明 |
|---|---|---|
result.location |
地区信息 | province、city、name、id 等 |
result.now.text |
实时天气现象 | 如“晴”“多云” |
result.now.temp |
实时气温 | 单位为摄氏度 |
result.now.wind_class / wind_dir |
实时风力风向 | 如“4级”“西南风” |
result.forecasts[] |
未来 7 天预报 | text_day、text_night、high、low、wd_day、wc_day 等 |
result.indexes[] |
生活指数 | 晨练、洗车、感冒、紫外线等 |
result.alerts[] |
气象预警 | 蓝色/黄色/橙色/红色预警 |
旧版本前端每天展示 7 天、每天 8 个字段(日期、白天天气、白天风向、白天风力、低/高温、夜间天气、夜间风向、夜间风力)。百度接口的 forecasts 恰好也返回 7 天,字段基本一一对应,转换成本很低:
| 前端老字段 | 百度接口字段 |
|---|---|
| 日期 | date(YYYY-MM-DD → MM/DD) |
| 白天天气 | text_day |
| 白天风向 | wd_day |
| 白天风力 | wc_day |
| 低/高温 | low / high |
| 夜间天气 | text_night |
| 夜间风向 | wd_night |
| 夜间风力 | wc_night |
(三)city code 转换
前面说过,前端只认识气象局的 city code,而百度 API 只认 district_id,所以转换表是这次升级的“翻译官”。
我最初让 AI 帮忙写了一个 convert_program.py,思路是:读入旧的 weather_get_for_server_v4.0_citylist.json(里面是“省份 → 城市名 → city code”),再读入从百度下载的 weather_district_id.csv(里面是“district_id、省、市、区县、经纬度”),用字符串相似度把两者匹配起来,生成 id_conversion_table.csv。
这张转换表最终长这样:
1 | old_id,new_id,province,city |
不过第一版转换表并不完美:2408 个城市里有 98 个没有匹配上。原因很现实——气象局的 city code 里混着大量“非行政区”的观测站(例如“乌伊岭”“小二沟”“珠峰大本营”这种),而百度天气接口基本只覆盖到区县一级,这些站自然匹配不到。
于是我又补了一个 complete_conversion_table.py,把这 98 个空缺按规则补齐:已经改名的区县映射到现在的名称,非行政区的观测站则回退到所属的县、市或最近的区划。例如“杜蒙”映射到“杜尔伯特”,“珠峰大本营”回退到“定日”。这样一来,转换表里 2408 行就全部有主了。
(四)前端兼容性处理
前端兼容的关键只有一句话:输出表的格式不要变。
老版本输出表每一行的结构是:
1 | code, province,city, [7 天 × 8 个字段] |
7 天 × 8 个字段,加上第一列的 code 和第二列的城市名,一共 58 列。前端 index.php 和 search.php 里所有按列号取值、按 / 切分温度的代码,都是基于这个约定写的。
因此新爬虫在写表时,仍然把旧 city code 放在第一列,城市名仍然写成 省,市,后面 7 天每个预报都严格映射成 8 个字段。前端几乎可以无感地继续运行。
1 | cells = [str(old_code), city_name] |
三、完整代码展示与部署
新版爬虫的完整代码是 weather_get_for_server_v4.3.1.py,部署时只需把它和转换表一起放到服务器目录,再让 run.sh 指向新文件即可:
1 |
|
运行逻辑沿用老版本的习惯:先生成 weather_get_for_server_v4.0_output.generating.tsv,全部跑完后再改名为 weather_get_for_server_v4.0_output.tsv,避免前端在爬取中途读到半成品。考虑到百度接口有调用频次限制,循环里仍然保留了每个城市 2 秒的间隔;完整跑一遍 2400 多个城市大概需要一个多小时。
四、局限性与未来可拓展方向
问题1:取数仍是“离线全量”模式,而不是实时查询
目前的做法是定时全量抓取,前端读的是抓好的 TSV。好处是前端不依赖第三方接口、响应快;坏处是数据存在滞后,而且每次全量抓取都要一个多小时。如果将来想改成“用户点开页面才实时查询”,后端可以进一步封装一个实时代理接口,但这会牵扯到 AK 的暴露和并发额度问题,需要重新设计。
问题2:98 个非行政区站号做了近似回退
气象局 city code 里有不少观测站并不是行政区,百度天气接口覆盖不到。这次升级里我给它们回退到了所属县市或最近的区划,功能上“有数据”,但严格来说显示的是邻近地区的天气。对这类站点,也许未来可以在地图上用坐标点来精确匹配,或者干脆在前端标注“邻近区域近似天气”。
问题3:AK 与额度是硬编码的
目前 AK 直接写在脚本常量里。个人使用没问题,但如果是多人协作或想开源,还是应该改成配置文件或环境变量,避免密钥泄露。额度、QPS 限制这类信息也值得在代码里做成可配置项。
未来的想法
- 给爬虫加上配置文件,把 AK、路径、请求间隔、重试次数都收敛到一份配置里。
- 在数据表之外,顺带保存一份 JSON 原始数据,方便以后做历史天气统计或重新生成不同格式的报表。
- 做一个简单的部署脚本,把“建目录、放文件、设 cron、跑首轮抓取”串起来,降低迁移到新服务器的成本。
4. (这一点DeepSeek在撰稿的时候没有想到,而是一位友人之前提出的建议)把整个网站服务做成一个小程序,增加更多个性化支持比如说衣物搭配、远方亲友关心提醒等。——我觉得这位朋友的建议非常有用!后面可以抽空安排上,嘻嘻。
以上。